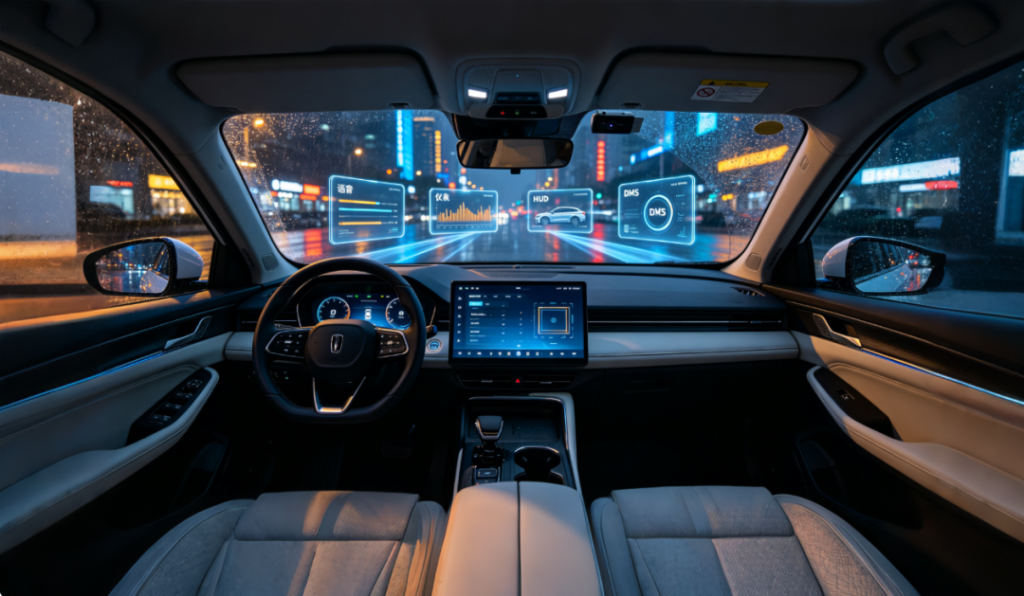
做了好几年车载测试,我发现一个挺有意思的现象。很多新人一上来就背测试用例,却说不清座舱里的语音、仪表、HUD、DMS 到底是怎么跑起来的。
这就像修车不看发动机原理,只记换哪个螺丝。能应付一时,遇到诡异 Bug 就抓瞎。
今天这篇,我用自己踩过的坑,把这四个子系统的工作原理和核心测试点,一次说透。建议收藏,后面做测试方案时翻出来对照。
一、语音交互系统:从唤醒到执行的全链路
语音是座舱里”存在感最强“的入口。你喊一声,车机得听懂、得回应、还得真的去执行。这条链路比很多人想的要长。
我习惯把它拆成七步。每一步都可能出问题,而且问题会层层放大。
 图片引自微信公众号,扫码关注阅读原文
简单过一遍。唤醒,就是车在后台一直听着,确认是不是在叫它。VAD(端点检测)负责判断你这句话从哪开始、到哪结束。ASR 把声音变成文字。NLU 理解文字背后的意图。DM 管理多轮对话的上下文。NLG 组织回复文案。最后 TTS 把文字念出来,同时车机去执行动作。
展开说几个新人容易懵的点。先是唤醒词。你可能会问,为什么唤醒词一般至少 3 个音节(比如”你好小 X“)?太短容易和日常对话撞车。比如单字”嗨”,音乐里的歌词、副驾随口一句话都可能含这个音,车机一旦误判就开始录音,既耗电又打扰。3 个音节给了足够大的区分度,误唤醒率才能压下来。这也是为什么几乎没人用车企单字做唤醒词。
再说 VAD(端点检测):很多人以为 VAD 是”检测有没有声音”,其实不是。它的任务是检测”人声从哪开始、到哪结束“,把一段连续录音里真正属于用户说话的那一截切出来,前后的静音段都丢掉。原理上靠能量阈值和过零率判断:能量够高、过零率又符合人声特征时,才认定是语音。难点在车内——路噪风噪能量也高,容易把噪声当成人声起点,或者把轻声说话的开头切掉,导致只识别到”后半句”。
ASR 内部其实是两个模型配合。声学模型负责把声音波形拆成音素(类似拼音的最小单元),语言模型再把这些音素拼成合理的字词。车噪会严重干扰声学模型,比如高速风噪下”空调”的发音可能被听成”到条”,这时就全靠语言模型根据上下文纠错(”到条”不是词,而”空调”是)。但语言模型也不是万能,噪声大到声学模型给错太多候选时,纠错也会失败。
到了 NLU,关键概念是”意图”和”槽位”。用户说”把空调调到 22 度”,意图是”控温”,槽位是”温度=22″。意图告诉系统”要干什么”,槽位补充”干到什么程度”。测试时不能只测一板一眼的标准说法,要验证同义说法——比如用户说”我热了”,能不能推出控温意图并把温度调低;说”调低两度”,能不能从当前温度正确算出目标值并填进槽位。覆盖的表达越多样,NLU 才越稳。
|
测试视角提醒:七步链路里,唤醒和 ASR 是重灾区。唤醒的通过率、误唤醒率、唤醒时延,几乎是每个车型必测的三项。ASR 的字准率直接决定”听懂没听懂”,这两个指标我下面展开讲。 |
核心测试点:几个硬指标
我整理过一份语音测试基准,这几个数基本是行业里常用的门槛,供你参考:
- 唤醒率
安静环境 > 95%,低噪 > 90%,中噪 > 80%,高噪 > 70%。注意,这是逐级下降的,高速上能稳在 70% 以上就不算差 - 误唤醒
48 小时内少于 1 次。这个指标很”玄学”,经常是某句广告词、某首歌的歌词把车叫醒了 - 唤醒时延
从喊出唤醒词到车机给出反馈,小于 1000ms。用户是能感知卡顿的,超过 1.5 秒就会觉得”没听见” - ASR 字准率
必过集(固定测试集)要求 100%,泛化集(自由说法)不低于 95%。泛化集才见真功夫
图片引自微信公众号,扫码关注阅读原文|
|
|
|
二、液晶仪表盘:CAN 信号驱动的实时显示
仪表是司机视线停留久的地方。它不像中控能”将就”,车速、转速、报警这些,差一点都可能出安全问题
仪表的工作原理,本质是一条从传感器到屏幕的数据链。我画了个简化版:
图片引自微信公众号,扫码关注阅读原文核心测试点
- 信号准确性
显示值与真实值偏差 ≤ 1(无量纲单位内)。比如车速表读 100,实车 100,不能显示 102 - 显示实时性
从信号变化到屏幕刷新,小于 100ms。司机踩油门,指针得立刻动 - 主题切换
经典/运动/简约主题切换时,布局、配色、仪表盘样式要正确,不能残留旧主题元素 - 报警显示优先级
安全带、ABS、胎压、电量低,这些报警有优先级。高优先级的必须盖住低优先级的,而且不能互相遮挡 - 多屏同步差
仪表和中控若显示同一信息(如导航剩余里程),同步差小于 100ms - 异常恢复
CAN 信号丢失、MCU 复位后,仪表要能自动恢复,不能黑屏或卡死
CAN 报文这块,测试同学至少得会抓包看信号。我贴一段典型的车速报文解析逻辑,方便你理解”信号怎么变成数字”:
// 假设车速信号在 CAN ID 0x316 的 byte2(高) + byte3(低),比例因子 0.1float parse_speed(uint8_t* frame) {uint16_t raw = (frame[2] << 8) | frame[3];return raw * 0.1; // km/h}// 测试用例:注入原始值 0x03E8(=1000) 期望显示 100.0 km/hassert(fabs(parse_speed(test_frame) - 100.0) < 0.05);
补充点底层知识,帮你理解上面那段代码为什么这么写。CAN 总线在物理层上是双绞线传输:CAN_H 和 CAN_L 两根线绞在一起,绞距大约 20mm。它用差分信号——真正有意义的不是某根线的绝对电压,而是两根线之间的电压差,共模干扰(两根线同时被噪声抬高或压低)在取差值时被抵消,所以抗干扰能力很强。总线两端还要各接一个 120 欧姆的终端电阻,用来匹配阻抗、消除信号在末端反射造成的振铃
报文本身也有固定结构。每条 CAN 报文带一个 Message ID,它不只是编号,还标识优先级——ID 越小优先级越高,总线冲突时小 ID 先发。后面是 DLC(数据长度码,0–8 字节)和真正的 Data 字段。像车速这种信号,ECU 通常按 10–100ms 的周期循环发送一次,所以仪表看到的不是一个实时值,而是一串”最近一次”的快照,这也是为什么信号丢失时仪表要能识别并做失效处理
再说刷新率。仪表为什么常用 60Hz(每秒 60 帧)?人眼对 30Hz 以上就感知为”流畅”了,但指针在快速移动时,30Hz 下每帧间隔约 33ms,高速转动的指针会留下肉眼可见的拖影和跳变感;60Hz 把间隔压到约 16ms,指针运动才足够平滑,司机余光扫过也不会觉得”一顿一顿“
|
|
三、HUD 抬头显示:光学反射与重影难题
HUD 是把信息投到挡风玻璃上,让司机不用低头看仪表。听起来酷,做起来难。难就难在”重影”
图片引自微信公众号,扫码关注阅读原文原理上,投影源(PGU)发出光,经过反射镜和透镜组折叠光路,打到挡风玻璃上,再反射进人眼,在前方 2–3 米形成虚像。问题出在挡风玻璃本身
挡风玻璃是双层夹胶结构。光打到玻璃上,外表面反射一次,内表面(夹层)又反射一次。两个反射面距离很近,人眼看到的就是一个主像 + 一个偏移的重影。白天强光下特别明显,像字”拖了影子”
|
|
再补充点投影和成像的背景,方便你理解测试为什么这么定。投影技术有三条路线:TFT-LCD 成本低、体积偏大、亮度一般,是当下主流方案;DLP(数字光处理)亮度高、对比度好、体积也小,但成本高,多见于高端车型;MEMS 激光方案功耗低、色彩表现好,但散斑问题还没完全解决,更多被视为未来方向。选哪条路线,本质上是在成本、亮度和体积之间做取舍
虚像距离为什么取 2–3 米?这和人眼对焦机制有关。人眼聚焦在 2 米外的物体时,看 HUD 信息和看前方路面几乎不需要切换焦距;如果虚像太近(比如 1 米),眼睛就得在 HUD 和路面之间反复对焦,反而增加视觉负担和疲劳。2–3 米是”既看得清、又不用频繁变焦”的折中区间
AR-HUD 和普通 HUD 差别很大。普通 HUD 只叠加固定信息(车速、转速等),位置基本不动;AR-HUD 则要先把导航箭头”贴”到真实路面上,这需要前向摄像头识别车道线、再和定位结果做融合,算出箭头该落在哪个空间位置。功能一复杂,测试维度就翻倍:不仅要测显示,还要测识别、融合、延迟
核心测试点
- 清晰度
至少覆盖白天、隧道、逆光、夜间四种光照。逆光和隧道进出口是清晰度掉得最厉害的场景 - 重影
不能只看正视角。侧视 30°、45°,以及强光环境下,重影往往会加重。这是工程师最容易漏测的点 - 亮度自适应
环境光变化时,HUD 亮度要跟着调。太暗看不清,太亮刺眼 - 显示位置
虚像高度、水平位置是否符合人因工程,不能挡住真实路况 - 稳定性
长时间运行不漂移、不闪烁、不偏色 - AR 导航融合
:箭头要准确贴合真实车道,偏移过大就失去意义 - 夜间模式
低亮度、低色温,避免干扰驾驶
四、DMS 驾驶员监测系统:从图像到预警的安全链路
DMS 是法规强相关的系统。疲劳驾驶、分心驾驶是事故高发原因,所以 DMS 几乎是新能源车的标配了
图片引自微信公众号,扫码关注阅读原文|
|
把疲劳判定的几个关键机制讲清楚,测试才知道该卡哪条线。PERCLOS 按字面就是”眼睛闭合时间占比”:PERCLOS = 闭眼帧数 / 总帧数 × 100%,通常按 1 分钟滑动窗口滚动计算。行业里阈值一般设 70%,也就是 1 分钟内闭眼累计超过 42 秒就判疲劳。但要注意,这个阈值对不同人群(比如天生眼裂小的人)需要单独校准
卡尔曼滤波在这里干什么?它不是每帧都直接判疲劳,而是用滤波算法平滑眨眼事件。原因很简单:单帧闭眼可能是正常眨眼(只持续 0.1–0.3 秒),只有”持续闭眼”才算疲劳。卡尔曼滤波能结合历史状态区分”短暂眨眼”和”真闭眼”,避免把一次正常眨眼误判成疲劳告警
从功能安全角度看,DMS 通常要求 ASIL-B 等级(依据 ISO 26262)。这意味着它要控制的故障率比 ASIL-A 更低,但还没到 ASIL-C/D 那种”关乎生命安全”的严苛程度。达到这个等级,测试时要做 FTA(故障树分析)和 FMEA(失效模式与影响分析),把”摄像头被挡“”算法输出异常“这类失效路径逐一梳理
还有个容易忽略的点:DMS 不是一直开着。它通常只在车速 > 15km/h 且挡位不是 P 档时才激活。停车等红灯时如果还判疲劳、狂报警,用户体验会很差。所以测试要专门验证激活条件——低速、P 档、临时停车这些场景,DMS 应该安静待机而不是误打扰
核心测试点
- 疲劳检测准确率
≥ 90%。用模拟疲劳样本(闭眼、点头)验证召回 - 分心检测
视线离开前方超过 2 秒应触发分心判定 - 特殊场景
戴眼镜、墨镜、口罩、帽子,都要覆盖。墨镜靠红外穿透,口罩帽子靠下半脸和头部姿态补偿 - 误报率
正常驾驶不能频繁误报,否则用户会关掉它 - 光照适应
隧道、夜间、强光,红外补光要稳 - 告警分级
L1 提示、L2 语音、L3 强告警,分级逻辑要符合预期 - 隐私安全
原始图像不出车端,本地处理,这是合规红线
|
|
五、多子系统联合测试:单独测完 ≠ 整车没问题
这是我最想强调的一章。很多团队把四个子系统分开测,各项都过,一上车联合跑就出幺蛾子
为什么?因为座舱是一个整体。语音下了指令,仪表要变、HUD 要投影、DMS 还在盯着你。信号在总线里打架,算力在 SoC 里抢资源,任何一个环节的时序没对齐,体验就崩了
图片引自微信公众号,扫码关注阅读原文三个典型联合场景
场景一:语音导航联动
你说”打开导航到公司”→中控显示路线→仪表同步目的地→HUD 投影转弯引导→DMS 同时监测你有没有看路。这里要测的是:四个屏幕的信息是不是同一个版本,延迟是不是在 100ms 内
场景二:疲劳主动干预
DMS 检测到疲劳→触发告警→语音主动问候”需要休息吗”→HUD 闪烁提醒→座椅震动。这条链要测的是:告警会不会重复打扰?震动和语音会不会冲突?
场景三:夜间墨镜行驶
戴墨镜夜间行驶→DMS 红外穿透继续监测→HUD 亮度自动降低→仪表切夜间模式。要测的是:模式联动是否顺滑,有没有”闪一下”的突兀切换
联合场景之所以容易出问题,根子在”资源共享”。给你三个常被忽略的角度:
SoC 资源竞争
四个子系统往往跑在同一颗座舱 SoC 上(比如高通 8155、8295 这类)。语音识别大量占用 CPU 时,可能拖累 HUD 的渲染帧率;DMS 的 AI 推理抢占 GPU 时,又可能让仪表渲染卡顿。测试时不能只看功能对不对,还要实时监控各子系统的 CPU / GPU / 内存占用,确认高负载下没人”饿死”
CAN 总线负载率
四个子系统的信号挤在同一条 CAN 总线上,负载率超过 70% 时丢帧概率会急剧上升。测试时要主动制造峰值负载——让所有子系统同时高频发送信号,看总线会不会丢帧、仪表会不会跳变、告警会不会延迟
电源管理降级
低电量模式下,各子系统可能被降频甚至关闭:DMS 和 HUD 谁先关?语音还能不能用?这些降级策略如果没定义清楚,用户就会遇到”突然某个功能没了”的困惑。降级顺序和可用性边界,都要写进测试用例
|
|
六、四子系统测试矩阵:一表掌握全部核心测试点
把前面四章揉成一张表,方便你做测试计划时直接抄作业。我按”工作原理关键词 / 核心指标 / 测试工具 / 常见 Bug / 测试难点”五个维度整理了
|
|
|
|
|
|
|
|---|---|---|---|---|---|
| 语音 |
|
|
|
|
|
| 仪表 |
|
|
|
|
|
| HUD |
|
|
|
|
|
| DMS |
|
|
|
|
|
下面这张图是上面表格的可视化版本:
图片引自微信公众号,扫码关注阅读原文七、避坑指南:5 个常见测试陷阱
写了这么多,我直接把最痛的 5 个坑列出来。每一条都是真金白银换来的经验
|
|
|
|
|
|
|
|
|
|
八、总结与行动清单
智能座舱的测试,说到底是在”人、车、环境”三者之间找平衡。四个子系统,各自有原理,合起来才是体验
座舱测试工程师能力地图
如果你打算往这个方向深耕,我建议按这条路径搭能力:
- CAN 基础
能抓包、能解析信号、能注入报文 - 信号分析
理解传感器到显示的数据流,知道延迟从哪来 - HMI 测试
界面、交互、人因工程,知道什么叫”好用” - 自动化
用脚本批量跑用例,把人从重复劳动里解放出来 - 场景设计
能设计联合场景,模拟真实用户的复杂操作
10 条行动清单
-
建立噪声场景矩阵,覆盖 4 类噪声区间。 -
语音唤醒率分级验收,高噪不低于 70%。 -
误唤醒做 48 小时长测,目标小于 1 次。 -
仪表实时性在动态工况下测,不只停车测。 -
HUD 重影测正、侧、强光三种视角。 -
DMS 覆盖墨镜、口罩、小眼睛等特殊场景。 -
多屏同步差纳入联合测试,门槛 100ms。 -
设计 3 个以上跨子系统联合场景。 -
告警分级逻辑逐一验证,避免冲突打扰。 -
隐私合规红线:面部数据不出车端。