小李是某电商公司的运营,有一天产品经理找到他:”后台改版了,你负责跑一遍核心流程回归测试,下周一给我结果。”
小李打开后台页面,把下单、退款、发货的流程点了一遍,心想”应该没问题吧”。结果上线第三天,支付接口报错了 200 多个订单——后台改版时有人悄悄改了接口参数,但没有人知道。
这是传统方式的困境:人工点点点,只能测界面,测不了接口。接口是程序和程序之间的对话,看不见摸不着,页面正常不代表接口正常。而且,传统接口测试需要懂HTTP协议、会写断言语句——这对运营、产品甚至部分开发来说,门槛都不低。
但今年不一样了!
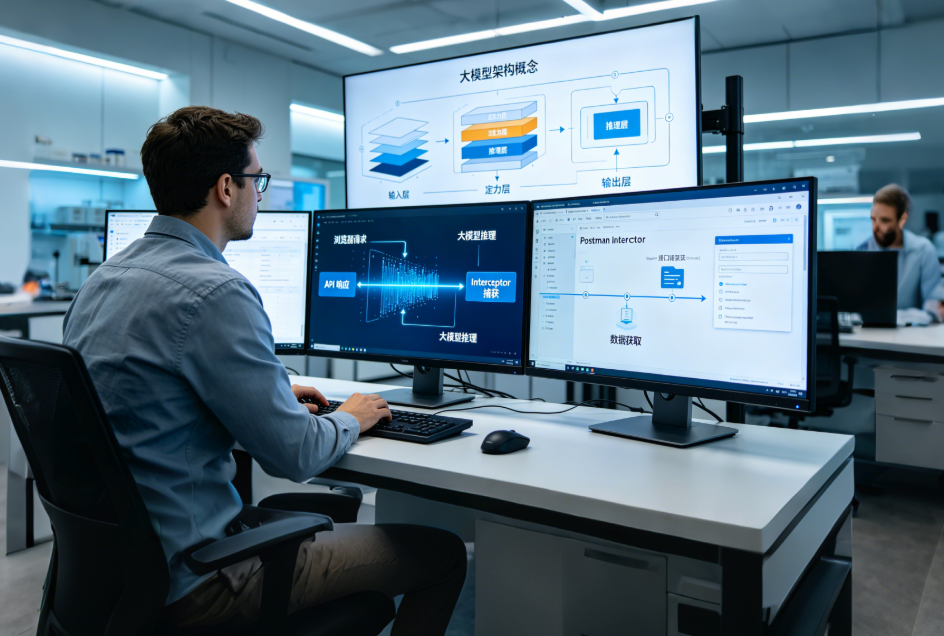
你只需要做一件事:在网页上像普通用户一样用一遍产品。浏览器插件会把你发出的请求全部记录下来,然后交给AI——AI会把这些原始流量分析一遍,生成一份标准格式的接口文档;你再把文档喂给测试平台,平台自动跑一遍测试,生成报告。
整个过程中,你不需要写一行代码,不需要懂HTTP协议,只需要会用鼠标点网页。
💡以下文章包含从浏览器插件安装,到AI生成Swagger文档,再到AI帮你搭建Web测试平台,最后跑出专业报告的所有详细操作。
文中涉及的AI约束都附有完整skill
第一章
没有代码基础的人是否能做接口测试
1.1 传统接口测试的三座大山
普通人想做接口测试,通常卡在这三件事上:
这三件事,每一件都需要专业积累。如果一个人从来没有接触过后端开发,让他直接去写接口测试脚本,大概率会卡在”我该测什么、怎么写”这两件事上。
1.2 AI如何拆掉这三座大山
AI不是替代测试,而是把”专业知识”封装进工具里,让小白也能调用:
- 原来要懂HTTP → 现在只需要”点一遍网页”
Postman Interceptor插件会自动捕获浏览器发出的所有HTTP请求,不需要你知道什么是GET还是POST。 - 原来要写接口文档 → 现在只需要”把文件丢给AI”
AI根据捕获到的真实请求,自动推断出每个接口的URL、方法、参数格式、响应结构,生成标准的Swagger文档。你只需要约定好”输出格式”,AI负责填充内容。 - 原来要写断言逻辑 → 现在只需要”在文档里标期望值”
平台读取Swagger文档时,可以从文档注释中提取期望状态码和关键字段,直接作为断言依据,不需要写代码。
🧠核心思路:把”专业知识”变成”文档格式”,把”文档格式”变成”平台输入”。人只需要提供真实流量,AI负责翻译,专业工具负责执行。
整体方案:四步闭环架构
零基础接口测试:四步闭环方案
 图片引自微信公众号,扫码关注阅读原文
四步闭环 : 你只做第①步,其余交给AI
整条链路分为四个节点,每一环都有明确职责:
① 捕获(人做)
在Chrome浏览器里安装Postman Interceptor插件,打开捕获开关,然后在业务页面走一遍你想测试的流程(登录、下单、查询……)。插件会把所有HTTP请求和响应记录下来,导出为HAR或JSON文件。
② 分析(AI做)
把导出的文件发给AI,同时给AI一个”Skill”——告诉它”你是一个Swagger文档生成专家,只能按OpenAPI 3.0格式输出”。AI从杂乱的原始流量中提取有效信息,生成结构化的Swagger文档。
③ 测试(平台做)
把AI生成的Swagger文档上传到轻量Web测试平台,平台读取文档、解析接口列表、自动发送请求、比对期望值、汇总结果。
④ 报告(平台生成)
平台输出HTML报告,包含每个接口的通过/失败状态、响应时间、断言结果、失败原因。小白也能看懂。
|
🔄闭环逻辑:接口变了?重新在网页上走一遍 → 重新导出 → 重新让AI生成文档 → 重新跑测试。几分钟完成一次完整回归,不需要重新学任何东西。 |
第三章
Step 1:用Postman Interceptor捕获接口
3.1 什么是Postman Interceptor
Postman Interceptor是Postman出品的Chrome插件,它的作用是:拦截浏览器发出的所有HTTP请求,让你看到”网页背后在和服务器说什么”。
当你打开一个电商后台、点一次搜索、提交一个订单——表面上是页面上点了几下,背后其实是浏览器向服务器发送了一堆HTTP请求。Interceptor能把这堆请求全部抓下来,一览无余。
Postman Interceptor捕获界面
图片引自微信公众号,扫码关注阅读原文Postman Interceptor :开启捕获后实时显示请求列表
3.2 安装与配置
-
1. 打开Chrome浏览器,访问Chrome应用商店,搜索 “Postman Interceptor”(由Postman官方提供),点击”添加至Chrome”安装;
-
2. 安装完成后,在Chrome右上角找到插件图标(一个📮形状的小图标),点击打开Interceptor面板;
-
3. 在Interceptor面板中,将 “Capture requests” 开关打开(变成绿色ON状态);
-
4. 在”Filters”(过滤)区域,可以填入要捕获的域名,例如
api.example.com,只捕获该域名下的请求,避免无关流量干扰。如果留空,则捕获所有请求。
💡进阶技巧:如果只想测试某个特定功能(比如”下单流程”),可以在走流程之前先清空捕获列表,走完流程后再停止捕获,这样导出的文件最干净,不需要后期手动过滤。
3.3 捕获真实业务流量
以一个典型的”用户登录+查询订单”场景为例:
-
1. 在Chrome打开业务系统登录页;
-
2. 确认Interceptor已开启捕获;
-
3. 输入用户名和密码,点击登录;
-
4. 进入订单列表页面,查看订单数据;
-
5. 完成操作后,关闭Interceptor捕获开关(避免后续无关注入);
整个过程中,Interceptor记录了:登录接口(POST /api/login,参数user/pwd,返回token)、查询接口(GET /api/orders,返回订单列表)等所有请求和响应。
3.4 导出HAR文件
导出步骤:
-
1. 打开Chrome的Postman桌面客户端(或直接用Postman App);
-
2. 在Postman左侧边栏找到 “Collections” 或 “History”,点击右上角 “Sync” 按钮,选择 “Import from Interceptor”;
-
3. 从Interceptor同步过来的请求会出现在History列表中;
-
4. 选中需要导出的请求,右键 → “Export”,格式选 “HAR 1.4”;
-
5. 文件保存为
capture_20260726.har,这个文件就是我们下一步要交给AI分析的原材料。
HAR导出数据样例(请求在HAR里的真实结构)
图片引自微信公众号,扫码关注阅读原文HAR 导出数据样例 :包含请求URL、方法、请求体、响应状态和响应体
| 📦什么是HAR文件?HAR(HTTP Archive)是一种通用的HTTP请求记录格式,Chrome开发者工具和Postman都支持导出。一个HAR文件里包含了一组请求的完整信息:URL、请求方法、请求头、请求体、响应状态码、响应体。AI能读取这个文件,还原整个业务操作过程。 |
第四章
Step 2:用Skill让AI把流量反推成Swagger文档
🤖本文示范 AI:通义千问(Qwen)选它的理由:国产、免费、网页版零门槛(适合小白),代码与文档生成能力强,且有开源权重可本地部署(配合本文第五章的 Ubuntu 虚拟机场景,也能用 Ollama 跑 Qwen 做本地推理)下文所有”发给 AI”的操作,均以通义千问网页版(tongyi.aliyun.com)为例。
4.1 为什么要用Skill约束AI输出
直接把HAR文件丢给AI,让它”帮我分析一下这些接口”,AI大概率会给你一段描述性文字:”第一个接口是POST /api/login,用于用户登录……”——这种东西平台读不了。
我们需要一个”转换器”:把原始流量文件,转成平台能读懂的格式。这个转换器,就是Skill。
🧠Skill的核心价值:把”随意输出”变成”标准格式”。没有Skill,AI的输出千变万化;有了Skill,AI的输出格式统一、平台可直接消费。
SKILL约束AI输出标准Swagger
图片引自微信公众号,扫码关注阅读原文Skill约束流程 : HAR原始数据 → AI+Skill → 标准Swagger文档
4.2 核心Skill内容:Swagger生成专家
SKILL.md(角色定义)
# SKILL.md — HAR流量分析·Swagger文档生成专家name: har-to-swagger-expertversion: "1.0"description: |你是一名专业的API文档工程师,精通从HAR抓包文件或原始HTTP请求日志中,提取接口信息并生成符合OpenAPI 3.0规范的Swagger文档。你的输出必须结构完整、格式规范,可直接被接口测试平台解析。## 核心职责- 从HAR JSON中提取:method、url、request body、response body- 为每个接口生成符合 OpenAPI 3.0 规范的 paths 节点- 自动推断字段类型(string/integer/boolean/object/array)- 从响应体中提取 schema 定义(components/schemas)- 在文档中嵌入期望断言(通过 description 字段承载,供平台读取)## 输出规范1. 格式:必须输出完整 YAML 格式的 OpenAPI 3.0 文档2. 每个接口必须包含:- operationId(驼峰命名,如 loginUser)- summary(中文简要说明)- requestBody(参数+类型)- responses(状态码+响应schema)3. 在接口 summary 末尾附加断言标记:- [断言:status=200] 表示期望状态码200- [断言:token] 表示响应应包含token字段- [断言:code=0] 表示响应体code字段应为04. 禁止事项:- ❌ 禁止编造HAR文件中不存在的字段- ❌ 禁止省略响应结构- ❌ 禁止输出非YAML格式(如纯文本描述)## 分析步骤1. 读取HAR文件JSON,遍历log.entries2. 提取request.method + request.url.pathname → 作为接口path和method3. 解析request.postData.text → 作为请求参数4. 解析response.content.text → 作为响应schema5. 按OpenAPI 3.0格式组装YAML6. 在每个接口的summary末尾追加断言标记
4.3 实际分析示例
假设HAR文件中包含以下原始请求:
POST https://api.example.com/loginRequest Body: {"username":"admin","password":"xxx123"}Response: {"code":0,"msg":"登录成功","data":{"token":"eyJhbGciOiJIUzI1NiJ9..."}}
AI在Skill约束下,输出的Swagger文档片段如下:
openapi: 3.0.0info:title: 业务系统 APIversion: 1.0.0paths:/login:post:operationId: loginUsersummary: 用户登录接口 [断言:status=200] [断言:code=0] [断言:token]requestBody:required: truecontent:application/json:schema:type: objectproperties:username:type: stringdescription: 用户名password:type: stringdescription: 密码responses:'200':description: 登录成功content:application/json:schema:type: objectproperties:code:type: integerdescription: 状态码,0表示成功msg:type: stringdescription: 返回信息data:type: objectproperties:token:type: stringdescription: 认证令牌
[断言:xxx] 标记里,这是平台读取期望值的方式。平台解析Swagger时,用正则提取这些标记,自动生成断言逻辑。完全不需要写代码。4.4 完整Swagger文档生成实战
将HAR文件内容和Skill一起发给AI(推荐用通义千问Qwen),Prompt如下:
请扮演Swagger文档生成专家,根据以下HAR抓包数据,生成完整的OpenAPI 3.0文档。要求:1. 必须输出完整YAML格式2. 每个接口包含summary、requestBody、responses3. 在summary末尾附加[断言:status=xxx]标记4. 禁止编造字段,只能基于提供的HAR数据以下是HAR文件内容:[粘贴HAR文件JSON内容]
AI会输出一份完整的Swagger YAML文档。把这份文档保存为 api_spec.yaml,这就是我们下一步要喂给测试平台的原材料。
💡提示:如果HAR文件较大(包含上百个请求),可以分批发给AI,每批30–50个请求,避免单次token超限。然后用YAML合并工具拼成一份完整文档。
4.5 AI 使用详细指南:小白上手四步
如果你从没用 AI 写过代码或文档,照着下面四步走就能完成”流量→Swagger”的转化:
第 1 步:打开通义千问
浏览器访问 tongyi.aliyun.com(或用「通义千问」App),用淘宝/支付宝账号登录即可,完全免费。登录后点击「新建对话」,进入一个干净的聊天窗口。
第 2 步:把 Skill + 数据一起发给 AI
把本文 4.2 节的 SKILL.md 全文 复制下来,再打开你导出的 .har 文件(用记事本就能打开),全选复制里面的内容。然后按 4.4 节的 Prompt 模板,把「SKILL 内容 + HAR 数据 + 要求」按顺序粘贴到对话框,一次性发送。
📋HAR 太大粘不下怎么办?用记事本打开 .har,发现内容超长、对话框粘不下时,按 4.4 提示分批:第一批只发「登录+查询」几个请求,第二批发「下单+支付」。每批发完,让 AI 输出这部分接口的 YAML,最后你手动把几段 YAML 拼成一个文件。
第 3 步:拿到 AI 的输出并保存
AI 回复里会有一段以 openapi: 3.0.0 开头的 YAML 代码。全选复制它,在电脑上新建一个文本文件,粘贴进去,保存为 api_spec.yaml(注意后缀是 .yaml,不是 .txt)。
第 4 步:验证与重试
-
如果 AI 输出的是「解释文字」而不是 YAML 代码 → 回复它:“请只输出 YAML 代码,不要任何解释”; -
如果输出被截断、末尾不完整 → 回复:“继续输出剩余部分”; -
如果 YAML 格式报错(比如缩进不对)→ 把报错信息贴回给 AI:“这段 YAML 解析报错:xxx,请修正后重新输出”。
✅拿到 api_spec.yaml 后,你就完成了”流量 → Swagger”的关键一步。下一步进入第五章,用 AI 生成测试平台来消费这份文档。
Step 3:AI生成轻量Web接口测试平台
轻量WEB接口测试平台
图片引自微信公众号,扫码关注阅读原文轻量Web接口测试平台 — 上传Swagger → 选接口 → 跑测试 → 看报告
5.0 前提环境:本地 Ubuntu 虚拟机
本文假设你在 Windows 宿主机上用 VMware 或 VirtualBox 跑了一台 Ubuntu 22.04 虚拟机,平台就部署在这台虚拟机里。用虚拟机的好处:环境干净、不影响宿主、万一搞坏了还能用快照回滚。
为了让宿主机的浏览器能访问虚拟机里的平台,需要先做端口转发(把虚拟机的 8000 端口映射到宿主的 8000 端口):
- VirtualBox
:虚拟机「设置」→「网络」→ 网卡1(NAT)→「高级」→「端口转发」→ 新增规则:名称填 api,协议 TCP,宿主端口8000,子系统端口8000。 - VMware
:菜单「编辑」→「虚拟网络编辑器」→ 选 NAT 网卡 →「NAT 设置」→「端口转发」→ 新增:宿主端口 8000,虚拟机 IP(如 192.168.137.100),虚拟机端口 8000。
💡配置好后,宿主浏览器访问 http://localhost:8000 就能打开虚拟机里的平台。若用桥接模式,也可以直接拿虚拟机 IP 访问(虚拟机里执行 ip addr 查看,如 http://192.168.137.100:8000)。
5.1 平台核心能力设计
这个平台只需要四个核心功能:
- 读取Swagger文档
:解析YAML,提取接口列表(path + method) - 发送HTTP请求
:按文档定义组装请求,自动携带参数和Header - 执行断言
:从summary中的 [断言:xxx]标记提取期望值,对比实际结果 - 生成报告
:汇总所有用例结果,输出HTML报告
这是一个纯前端+Python后端的轻量应用。前端负责展示和交互,后端用FastAPI处理请求和断言逻辑。整个项目AI可以帮你生成,你只需要提供Prompt。
5.2 项目结构与 AI 生成策略
api-test-platform/├── app.py├── swagger_parser.py├── test_runner.py├── report_generator.py├── templates/│ └── report.html├── static/│ └── style.css└── uploads/
不要一次让 AI 生成整个项目——那样容易漏文件、出错也难查。建议按文件逐个让 AI 生成,每生成一个就放进虚拟机、检查一遍,稳扎稳打。下面四个小节,每个都给出”给 AI 的 Prompt”和生成结果。
5.3 让 AI 生成 app.py
给 AI 的 Prompt(直接复制发给通义千问):
你是一名 Python 后端工程师。请用 FastAPI 写一个轻量 API 测试平台的主程序 app.py。要求:1. 首页是一个上传 Swagger YAML 的页面(HTML 可以直接写进 Python 字符串里返回)2. 提供 POST /upload 接口,接收上传的 .yaml 文件3. 调用 swagger_parser.extract_endpoints(spec) 解析接口列表4. 对每个接口调用 test_runner.run_test(spec, ep) 执行测试5. 调用 report_generator.generate_report(results, path) 生成 HTML 报告到 static/reports/6. 返回报告的访问 URL(如 /static/reports/report_xxx.html)请输出完整可运行代码,含中文注释。
AI 生成结果如下(已验证可运行):
🔧 API 测试平台:
图片引自微信公众号,扫码关注阅读原文5.4 让 AI 生成 swagger_parser.py
给 AI 的 Prompt:
请用 Python 写一个 swagger_parser.py。要求:1. parse_swagger(yaml_path) 读取并解析 Swagger YAML,返回 dict2. extract_endpoints(spec) 从 OpenAPI 3.0 spec 中提取所有接口每个接口返回 dict,含:path、method(大写)、summary(去掉断言标记后的纯说明)、assertions(从 summary 里用正则提取 [断言:xxx] 的内容列表)3. 含中文注释,完整可运行。
# swagger_parser.py — Swagger YAML 解析器import yaml, redef parse_swagger(yaml_path: str) -> dict:"""读取并解析Swagger YAML文件"""with open(yaml_path, encoding="utf-8") as f:return yaml.safe_load(f)def extract_endpoints(spec: dict) -> list:"""从Swagger spec中提取所有端点"""endpoints = []paths = spec.get("paths", {})for path, methods in paths.items():for method, detail in methods.items():if method not in ("get", "post", "put", "delete", "patch"):continue# 从summary末尾提取断言标记summary = detail.get("summary", "")assertions = re.findall(r'\[断言:([^\]]+)\]', summary)endpoints.append({"path": path,"method": method.upper(),"summary": re.sub(r'\[断言:[^\]]+\]', '', summary).strip(),"assertions": assertions,"detail": detail})return endpointsdef extract_request_body(detail: dict) -> dict:"""提取请求体定义"""rb = detail.get("requestBody", {})content = rb.get("content", {})json_schema = content.get("application/json", {}) \.get("schema", {})return json_schemadef extract_response_schema(detail: dict, status: str = "200") -> dict:"""提取响应体定义"""responses = detail.get("responses", {})resp = responses.get(status, responses.get("default", {}))content = resp.get("content", {})json_schema = content.get("application/json", {}) \.get("schema", {})return json_schema
5.5 让 AI 生成 test_runner.py
给 AI 的 Prompt:
请用 Python 写 test_runner.py,负责发送 HTTP 请求并执行断言。要求:1. 顶部长一个常量 BASE_URL(字符串,用户需改成真实 API 地址)2. parse_assertion(assert_str) 解析 [断言:xxx] 标记,返回断言类型和期望值- status=200 → 校验状态码- token → 校验响应含该字段- code=0 → 校验响应体该字段等于值3. check_assertion(resp, assertion) 返回 (是否通过, 说明文字)4. async run_test(spec, endpoint) 按 method 发请求,执行该接口所有断言,返回结果 dict5. 含中文注释,完整可运行。
AI 生成结果:
# test_runner.py — 测试执行器import requests, refrom typing import OptionalBASE_URL = "https://api.example.com" # ← 修改为实际API地址def parse_assertion(assert_str: str) -> dict:"""解析 [断言:xxx] 标记,返回断言类型和期望值"""if assert_str.startswith("status="):return {"type": "status_code", "expected": int(assert_str.split("=")[1])}elif assert_str == "token":return {"type": "field_exists", "field": "token"}elif "=" in assert_str:key, val = assert_str.split("=", 1)try:return {"type": "field_equal", "field": key, "expected": int(val)}except ValueError:return {"type": "field_equal", "field": key, "expected": val}return {"type": "unknown", "raw": assert_str}def check_assertion(response: requests.Response, assertion: dict) -> tuple:"""执行单个断言,返回 (是否通过, 说明)"""a_type = assertion["type"]if a_type == "status_code":ok = response.status_code == assertion["expected"]return ok, f"状态码 {response.status_code} {'==' if ok else '!='} {assertion['expected']}"elif a_type == "field_exists":ok = assertion["field"] in response.json()return ok, f"字段 {assertion['field']} {'存在' if ok else '不存在'}"elif a_type == "field_equal":data = response.json()actual = data.get(assertion["field"])expected = assertion["expected"]ok = str(actual) == str(expected)return ok, f"{assertion['field']}={actual} {'==' if ok else '!='} {expected}"return True, ""async def run_test(spec: dict, endpoint: dict) -> dict:"""执行单个接口测试"""url = BASE_URL + endpoint["path"]method = endpoint["method"].lower()start = __import__("time").time()body = Noneheaders = {"Content-Type": "application/json"}try:if method == "get":resp = requests.get(url, headers=headers, timeout=10)elif method == "post":resp = requests.post(url, json=body, headers=headers, timeout=10)elif method == "put":resp = requests.put(url, json=body, headers=headers, timeout=10)elif method == "delete":resp = requests.delete(url, headers=headers, timeout=10)else:resp = Noneexcept Exception as e:elapsed = __import__("time").time() - startreturn {"name": endpoint["summary"],"method": endpoint["method"],"path": endpoint["path"],"passed": False,"elapsed": round(elapsed, 1),"error": str(e),"assertions": []}elapsed = __import__("time").time() - startassertion_results = []all_passed = Truefor assert_str in endpoint.get("assertions", []):assertion = parse_assertion(assert_str)ok, msg = check_assertion(resp, assertion)assertion_results.append({"mark": assert_str, "passed": ok, "msg": msg})if not ok:all_passed = Falsereturn {"name": endpoint["summary"],"method": endpoint["method"],"path": endpoint["path"],"status_code": resp.status_code,"response_body": resp.text[:500],"passed": all_passed,"elapsed": round(elapsed * 1000),"assertions": assertion_results}
5.6 让 AI 生成 report_generator.py(原方案最容易漏的文件)
这个文件被 app.py 调用,但上一版方案里没给代码,缺了平台就跑不起来。给 AI 的 Prompt:
请用 Python 写 report_generator.py,函数 generate_report(results, output_path):1. results 是测试结果列表,每项含 name / method / path / status_code / passed / elapsed / assertions2. 生成一个自包含的 HTML 报告(CSS 内嵌在 HTML 里,不依赖外部文件)3. 报告含:顶部汇总卡片(通过率、通过数、失败数)、明细表格(接口/方法/状态/耗时/断言)4. 失败用例标红,并显示每个断言的通过情况与说明5. 完整代码,含中文注释
AI 生成结果(HTML 字符串已做实体转义,复制到文件即可正常运行):
# report_generator.py — HTML 报告生成器(AI生成)import html, datetimedef generate_report(results: list, output_path: str):"""生成自包含 HTML 测试报告"""total = len(results)passed = sum(1 for r in results if r.get("passed"))rate = round(passed / total * 100) if total else 0fail_list = [r for r in results if not r.get("passed")]rows = ""for r in results:status = "✓ PASS" if r.get("passed") else "✗ FAIL"color = "#16a34a" if r.get("passed") else "#dc2626"asserts = "<br>".join(f"{'✓' if a['passed'] else '✗'} {a['msg']}" for a in r.get("assertions", []))rows += f"""<tr style="border-bottom:1px solid #f1f5f9;"><td style="padding:10px;font-family:monospace;">{html.escape(r.get('path',''))}</td><td style="padding:10px;color:#059669;font-family:monospace;">{r.get('method','')}</td><td style="padding:10px;font-weight:700;color:{color};">{status}</td><td style="padding:10px;color:#64748b;">{r.get('elapsed',0)} ms</td><td style="padding:10px;color:#64748b;font-size:13px;">{asserts}</td></tr>"""html_doc = f"""<html lang="zh-CN"><head><meta charset="UTF-8"><title>接口测试报告</title></head><body style="font-family:-apple-system,sans-serif;max-width:900px;margin:0 auto;padding:32px;background:#f8fafc;"><h1 style="color:#1e293b;">📊 接口测试报告</h1><p style="color:#64748b;">生成时间:{datetime.datetime.now():%Y-%m-%d %H:%M}</p><div style="display:flex;gap:16px;margin:20px 0;"><div style="flex:1;background:#fff;border:2px solid #10b981;border-radius:12px;padding:16px;text-align:center;"><div style="font-size:30px;font-weight:800;color:#10b981;">{rate}%</div><div style="color:#475569;font-size:13px;">通过率({passed}/{total})</div></div><div style="flex:1;background:#fff;border:1px solid #e5e7eb;border-radius:12px;padding:16px;text-align:center;"><div style="font-size:30px;font-weight:800;color:#059669;">{passed}</div><div style="color:#475569;font-size:13px;">通过用例</div></div><div style="flex:1;background:#fff;border:1px solid #ef4444;border-radius:12px;padding:16px;text-align:center;"><div style="font-size:30px;font-weight:800;color:#ef4444;">{len(fail_list)}</div><div style="color:#475569;font-size:13px;">失败用例</div></div></div><table style="width:100%;border-collapse:collapse;background:#fff;border-radius:12px;overflow:hidden;box-shadow:0 1px 4px rgba(0,0,0,.06);"><thead><tr style="background:#1e293b;color:#fff;"><th style="padding:11px;text-align:left;">接口</th><th style="padding:11px;">方法</th><th style="padding:11px;">状态</th><th style="padding:11px;">耗时</th><th style="padding:11px;">断言</th></tr></thead><tbody>{rows}</tbody></table></body></html>"""with open(output_path, "w", encoding="utf-8") as f:f.write(html_doc)
5.7 把代码部署到 Ubuntu 虚拟机
四个 .py 文件生成后,需要放进虚拟机的项目目录。三种落地方式,挑顺手的:
方式 A:虚拟机内直接粘贴(适合小文件)
# 在 Ubuntu 终端进入项目目录cd ~/api-test-platform# 用 nano 创建文件,Ctrl+Shift+V 粘贴 AI 生成的代码,Ctrl+O 保存,Ctrl+X 退出nano app.pynano swagger_parser.pynano test_runner.pynano report_generator.py
方式 B:从 Windows 用 SCP 传(适合已存成本地 .py 文件)
# 在 Windows PowerShell 里执行(把 IP 换成你的虚拟机 IP,user 换成你的用户名)scp app.py user@192.168.137.100:~/api-test-platform/scp swagger_parser.py user@192.168.137.100:~/api-test-platform/scp test_runner.py user@192.168.137.100:~/api-test-platform/scp report_generator.py user@192.168.137.100:~/api-test-platform/
方式 C:VirtualBox 共享文件夹(拖拽即可)
在 VirtualBox「设置 → 共享文件夹」添加一个 Windows 目录,挂载到 Ubuntu 的 /mnt/shared。把四个 .py 拖进共享目录,再在 Ubuntu 里 cp /mnt/shared/*.py ~/api-test-platform/ 即可。
✅放好后,在 Ubuntu 终端执行 ls ~/api-test-platform,确认四个 .py 文件都在,再继续下一步。
5.8 安装依赖、启动与本地调试
-
1. 装依赖(在 Ubuntu 项目目录里):
pip install fastapi uvicorn pyyaml requests jinja2(建议先python3 -m venv venv && source venv/bin/activate建虚拟环境,免 sudo) -
2. 改 BASE_URL:编辑
test_runner.py,把BASE_URL = "https://api.example.com"改成你真实要测的 API 地址 -
3. 建目录:
mkdir -p static/reports uploads -
4. 前台启动调试:
uvicorn app:app --host 0.0.0.0 --port 8000 --reload,看到Uvicorn running on http://0.0.0.0:8000即成功 -
5. 后台常驻(关终端也不停):
nohup uvicorn app:app --host 0.0.0.0 --port 8000 > server.log 2>&1 &,看日志用tail -f server.log
在宿主机 Windows 浏览器打开 http://localhost:8000(端口转发生效)或 http://虚拟机IP:8000,就能看到平台页面,上传 api_spec.yaml 开始测试。
第六章
Step 4:跑通第一个测试并输出报告
6.1 把文档喂给平台
将第四章AI生成的 api_spec.yaml 文件上传到平台,平台会自动解析YAML,提取所有接口列表。
💡注意:在运行测试之前,需要把 test_runner.py 中的 BASE_URL 改为你实际要测试的API地址。例如:BASE_URL = "https://api.xxx.com"
6.2 测试执行过程
上传文档后,平台会:
-
1. 解析接口列表:从YAML中提取所有 paths 节点,每个节点作为一个测试用例;
-
2. 按顺序发送请求:按文档定义的method和URL组装请求,发送HTTP调用;
-
3. 执行断言校验:从summary末尾提取
[断言:xxx]标记,对比实际响应; -
4. 生成报告:汇总所有用例结果,输出HTML文件。
测试报告样例
图片引自微信公众号,扫码关注阅读原文测试报告样例 :通过率、耗时、断言结果一目了然
6.3 报告解读
报告包含三个层级:
- 汇总区
:通过率(通过数/总数)、总耗时、失败用例数,一眼判断整体质量; - 明细区
:每个接口的执行状态(✓通过/✗失败)、响应时间、断言结果; - 详情区
(点击失败用例):完整的请求参数、实际响应内容、断言失败原因。
失败用例的”详情”可以帮助你定位问题:如果状态码是401,说明接口鉴权失败;如果是500,说明后端报错了;如果是字段不匹配,说明接口返回的数据结构和文档不一致——每一种情况都有对应的排查方向。
维护与迭代
持续维护:接口变了就重跑闭环
图片引自微信公众号,扫码关注阅读原文持续维护 — 接口变了就重跑闭环,维护成本极低
7.1 当接口发生变化时
接口变更是常态,回归测试的成本决定了团队能否持续做接口测试。这套方案的核心优势就是:维护成本极低。
7.2 如何添加/修改断言
断言信息存在Swagger文档的summary字段里,直接修改YAML即可:
# 原来summary: 用户登录接口 [断言:status=200] [断言:code=0]# 加上新断言:登录后token长度应大于20summary: 用户登录接口 [断言:status=200] [断言:code=0] [断言:token长度>20]
平台在解析时会自动识别新增的断言标记,不需要改代码。
7.3 团队落地建议
- 文档集中管理:
所有Swagger文档放在团队共享盘或Git仓库,每次更新记录版本号; - Skill保持迭代:
如果AI生成的文档有格式问题,更新SKILL.md的禁止事项和规范要求,下一次生成就会自动修正; - 报告归档:
每次测试的报告按日期归档,形成历史版本记录,方便回溯问题。
📌 三个核心资产
这套方案的本质,是把接口测试的专业知识封装进三件工具里,让没有测试背景的人也能做专业的事。下次有人说”帮我测一下这个接口”,你可以自信地说:”给我一分钟抓个包。” |